Ultralytics YOLO26: Unified Real-Time End-to-End Vision Models
原文地址:Ultralytics YOLO26: Unified Real-Time End-to-End Vision Models
摘要
Real-time vision demands models that are accurate, efficient, and simple to deploy across diverse hardware. The YOLO family has become widely deployed for this reason, yet most YOLO detectors still rely on non-maximum suppression at inference, carry heavy detection heads due to Distribution Focal Loss, require long training schedules, and can leave the smallest objects without positive label assignments. We present Ultralytics YOLO26, a unified real-time vision model family that addresses these limitations through coordinated architecture and training advances. YOLO26 uses a dual-head design for native NMS-free end-to-end inference and removes DFL entirely, yielding a lighter head with unconstrained regression range. Its training pipeline combines MuSGD, a hybrid Muon-SGD optimizer adapted from large language model training; Progressive Loss, which shifts supervision toward the inference-time head; and STAL, a label assignment strategy that guarantees positive coverage for small objects. Beyond detection, YOLO26 introduces task-specific head and loss designs for instance segmentation, pose estimation, and oriented detection, producing consistent gains across tasks and scales. The family spans five scales (n/s/m/l/x) and supports detection, instance segmentation, pose estimation, classification, and oriented detection in a single pipeline, with an open-vocabulary extension, YOLOE-26, for text-, visual-, and prompt-free inference. Across all scales, YOLO26 achieves 40.9-57.5 mAP on COCO at 1.7-11.8 ms T4 TensorRT latency, advancing the accuracy-latency Pareto front over prior real-time detectors, while YOLOE-26x reaches 40.6 AP on LVIS minival under text prompting. Code and models are available at this https URL.
实时视觉需要准确、高效且易于在不同硬件上部署的模型。YOLO系列因此被广泛部署,然而大多数YOLO检测器在推理时仍依赖非极大值抑制(NMS)、因分布聚焦损失(DFL)导致检测头过重、需要长时间训练、且可能使极小物体没有正标签分配。我们提出Ultralytics YOLO26,一个统一的实时视觉模型系列,通过协调的架构和训练改进来解决这些局限性。YOLO26采用双头设计实现原生无NMS的端到端推理,并完全移除DFL,从而得到更轻且回归范围无约束的检测头。其训练流程结合了MuSGD(一种从大语言模型训练中改进的混合Muon-SGD优化器)、Progressive Loss(将监督逐渐转移到推理时的检测头)以及STAL(一种保证小物体正标签覆盖的标签分配策略)。在检测任务之外,YOLO26还引入了针对实例分割、姿态估计和旋转检测的任务特定检测头和损失设计,在各类任务和模型规模上均取得一致的性能提升。该系列包含五个规模(n/s/m/l/x),在单一流程中支持检测、实例分割、姿态估计、分类和旋转检测,并提供开放词汇扩展YOLOE-26,支持文本、视觉和无需提示的推理。在所有规模上,YOLO26在COCO上以1.7-11.8 ms T4 TensorRT延迟达到40.9-57.5 mAP,相比先前的实时检测器提升了精度-延迟帕累托前沿,而YOLOE-26x在LVIS minival上通过文本提示达到40.6 AP。代码和模型请访问此链接。
引言
YOLO 系列发展到今天,已经不仅仅是目标检测的代名词,而成了一套「精度够用、部署简单、硬件友好」的实用主义标准。但 YOLO26 这篇论文在引言里坦白承认:即便是当前最成熟的 YOLO 检测器,仍然有几块硬骨头没有啃下来。
检测器的发展线索
要理解 YOLO26 做了什么,先回顾一下实时目标检测的演变路径。
最早的方案是两阶段检测器,比如 Faster R-CNN,先提候选框再分类,精度高但速度慢。后来 SSD、RetinaNet、YOLOv3 这些单阶段检测器用密集预测代替候选框生成,大幅降低了延迟。再往后,FCOS 和 YOLOv8 去掉了锚框,进一步简化检测头;YOLOv10 引入了双重分配机制,实现了无 NMS 推理。与此同时,DETR 把检测当成集合预测问题来做,后续的 RT-DETR、D-FINE、DEIM 等实时衍生模型在标准基准上已经追上了 CNN 检测器。
不过,这些基于 Transformer 的模型往往需要大规模预训练的视觉骨干、可变形注意力等自定义算子,或者固定输入分辨率,在跨硬件部署时灵活度不如 YOLO。
YOLO 系列能在工业界稳住地位,论文归结为两个原因:
- 部署通用性强:依赖标准卷积算子,可以原生导出到 TensorRT、ONNX、CoreML、TFLite、OpenVINO、NCNN、ExecuTorch 等几乎所有主流推理后端,覆盖云、移动、嵌入式。
- 多任务统一:一个骨干网络 + 颈部结构就能同时支持目标检测、实例分割、分类、姿态估计、旋转框检测。
但还是有四个问题没解决。
YOLO 当前的四块短板
1. NMS 依赖 + 双头训练不平衡
大多数 CNN 检测器推理时还离不开 NMS。YOLOv10 虽然用双头设计去掉了 NMS,但训练时两个头共享相同的损失权重——实际推理只用一对一分支,它跟密集的一对多分支承受同样的优化压力,得不到更有针对性的训练。
2. DFL 带来的参数膨胀和范围限制
从 YOLOv8 开始引入的 DFL,把边界框回归从 4 个标量变成了每个位置 4K 个 logits(通常 K=16),检测头参数大幅膨胀。论文给了一组直观的数据:YOLO11n 带着 DFL 是 2.6M 参数 / 6.5 GFLOPs,去掉 DFL 降到 2.3M 参数 / 5.2 GFLOPs——仅这一个模块就占了 12% 的参数和 20% 的计算量。而且 DFL 对每侧有固定的回归范围限制((K−1) × stride 像素),在高分辨率下对大物体不友好。D-FINE 通过增大 K 来缓解,但额外 bin 又进一步加重了检测头的负担。
3. 训练周期长
标准 SGD 方案大约要训 600 个 epoch 才能在 COCO 上达到有竞争力的精度,迭代成本很高。最近 Muon 优化器在大语言模型训练中展示出约 2 倍于 AdamW 的计算效率,但之前没人把它用到目标检测上。
4. 小物体的标签分配真空
TAL 策略基于几何包含关系在真实框内选候选锚点。经过多层降采样后,空间尺寸小于最小 stride 的物体在框内一个锚点都落不进去,直接拿到零正分配、零梯度信号——这些小物体相当于在训练中被忽略了。
YOLO26 怎么解决
YOLO26 基于 YOLO11,核心改动集中在四个方向:
- 架构上,采用双头设计实现原生无 NMS 推理,同时彻底移除 DFL,回归头更轻、回归范围不受限。
- 训练上,引入三个互补组件:
- MuSGD:从 LLM 训练借鉴的混合 Muon-SGD 优化器,加速收敛
- Progressive Loss:逐步将监督信号转向推理时的一对一头
- STAL(小目标感知标签分配):在 TAL 基础上保证小物体也能分到正候选
- 任务扩展上,为分割、姿态、旋转检测分别设计专用头:
- 分割:多尺度原型融合 + 辅助语义监督
- 姿态:基于 RLE 的不确定性感知关键点回归
- 旋转检测:改进的长边角度公式 + 角度专用监督
- 开放词汇:YOLOE-26 将 YOLOE 框架搬到 YOLO26 上,换上了更强的文本编码器(MobileCLIP2),加了伪标签数据引擎和解耦分割训练,LVIS minival 上文本提示达到 40.6 AP。
效果如何
全规模上 YOLO26 对比 YOLO11:
- COCO 实例分割:mask AP 最高 +3.7
- COCO 关键点姿态 AP:最高 +7.2
- DOTA-v1.0 旋转检测 mAP:最高 +3.4
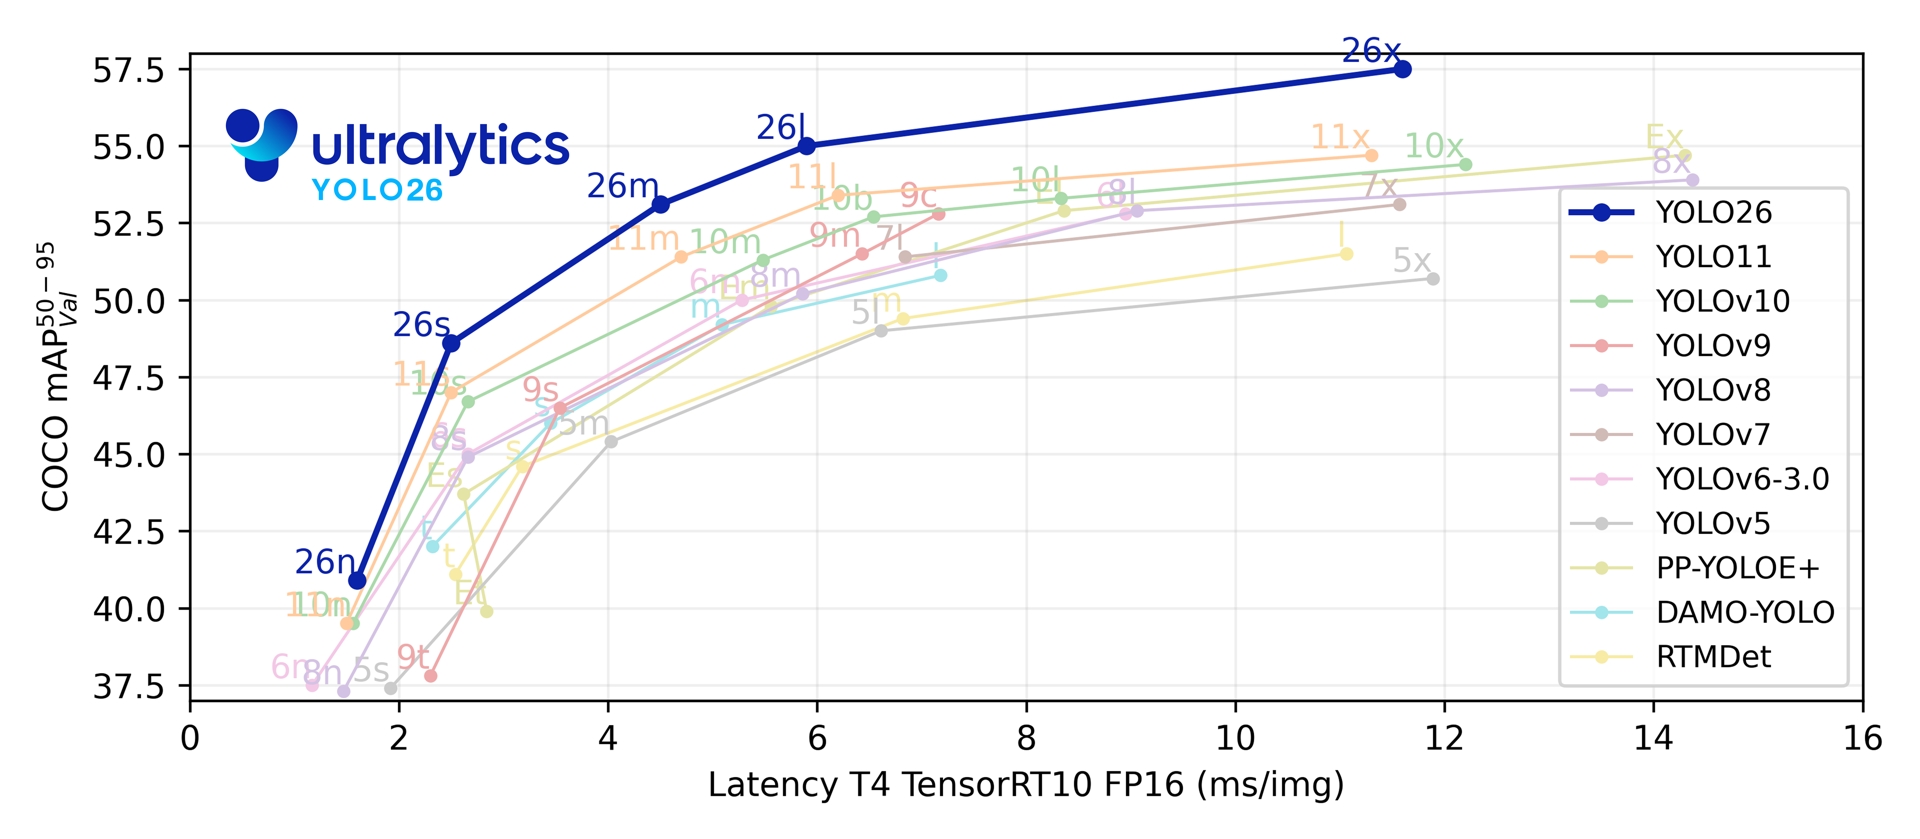
在 COCO val2017 的精度-延迟曲线上,YOLO26 在中到大规模段明显推进了帕累托前沿,同等规模下相比 YOLO11 提升 1.6–2.8 AP。
本文的主要贡献
总结起来就是四点:
- 无 DFL 的双头架构:原生无 NMS 端到端推理,回归头更轻、范围不受限,同时保留密集分支给精度优先的场景。
- 三件套训练流程:MuSGD + Progressive Loss + STAL 联合使用,加快收敛、对齐推理路径、覆盖小物体。
- 三个任务特定扩展:分割、姿态、旋转检测各自有专用设计,且在统一系列下都取得了增益。
- YOLOE-26 开放词汇扩展:升级编码器、伪标签引擎、解耦训练,文本提示下 40.6 AP。
相关工作
YOLO26 不是从零开始造的轮子,它站在好几个方向上已有的积累上。论文把相关工作分成六个子领域来梳理。
2.1 CNN 检测器:两阶段 → 单阶段 → 无 NMS
CNN 检测器这条线演进得很规律:先做两阶段打底,然后一路做减法。
两阶段这边,R-CNN → Fast R-CNN → Faster R-CNN 逐步把候选区域提取也并入网络,实现了端到端训练和当时最好的速度-精度权衡。单阶段检测器更激进,直接去掉候选框阶段,在特征图上做密集预测。SSD 用 default boxes 做了高效的多尺度密集预测,RetinaNet 用 Focal Loss 解决正负样本不平衡问题。YOLOv3 和 YOLOv5 则在多尺度预测和训练策略上不断打磨。
再往后是无锚框路线。FCOS 把检测变成了逐像素分类加框回归,去除手工设计的锚框,便于跨数据集移植。CenterNet 则用关键点和几何关系来表示物体。YOLOv8 也走了这个方向,用无锚框的分裂头设计。
最近的目标是去掉后处理 NMS。YOLOv10 通过一致的双重分配实现了无 NMS 推理——两个训练分支,一个一对多分支做密集监督,一个一对一分支学每个真实框的唯一匹配预测,推理时直接解码。
2.2 Transformer 检测器
Transformer 把检测做成了端到端的集合预测,用匈牙利匹配做一对一分配,锚框和 NMS 都省了。DETR 是开山之作,之后 Deformable DETR 通过可变形注意力提升了效率和收敛速度,引入了迭代框细化和两阶段候选初始化。后续的工作在查询设计和训练上持续改进:DAB-DETR 把查询参数化为可学习的锚框,DN-DETR 用带噪声的真实框构建去噪查询来加速收敛,DINO 结合了混合查询选择、对比去噪等策略。H-DETR 和 Group DETR 在训练时保留一对多分配来增加监督,推理时仍用一对一。
Transformer 也被搬到了实时场景。RT-DETR 通过高效的编码器设计实现实际可用的速度-精度权衡,RT-DETRv4 探索了更强的蒸馏策略。D-FINE 和 DEIM 在定位和训练优化上做了改进。LW-DETR 为低延迟部署精简架构,RF-DETR 则构建了有竞争力的实时 Transformer 检测器家族。
2.3 实例分割
实例分割这边,Mask R-CNN 用 RoI 对齐的 mask 分支给两阶段检测器加上了像素级分割能力。为了避开逐 RoI 的计算开销,无候选框方法做了全卷积预测:CondInst 通过动态预测卷积参数来生成实例条件化的 mask 头,SOLOv2 则按位置预测动态 mask 核。
实时场景下,基于原型的方法最实用。YOLACT 预测全局原型掩膜再加实例系数的线性组合,配合裁剪得到最终 mask,速度快且精度够用。YOLO 系列的分割头一直沿用这套原型-系数方案。Transformer 这边,Mask2Former 用带掩膜注意力的解码输出实例掩膜集合,MaskDINO 进一步引入了去噪训练来提升掩膜质量。
2.4 姿态估计
姿态估计从直接的坐标回归(DeepPose)演变到热图预测,Stacked Hourglass 和 SimpleBaselines 奠定了编解码结构,HRNet 靠并行子网络融合保持高分辨率特征,OpenPose 则走自底向上路线联合预测关键点和部位亲和场。ViTPose 展示了 Transformer 骨干的可扩展性,RTMPose 用 CSPNeXt 加坐标分类头做到了实时。
YOLO 系的姿态估计:YOLO-Pose 最早去掉了热图,用单阶段端到端公式联合检测人和回归关键点。YOLOv7 加入了关键点头,YOLOv8 和 YOLO11 延续了无锚框姿态头的方向。YOLO26 在这条直接回归线路上进一步引入 RLE,用基于归一化流的概率目标函数替代传统回归,让关键点定位更准也更稳。
2.5 旋转框检测
旋转框检测主要是为航拍图像和场景文本服务的——直立框在这些场景下重叠太大。早期方案把旋转锚框塞进候选区域网络,RoI Transformer 和 Oriented R-CNN 则用旋转感知的头来做。
核心难点是角度表示。朴素回归会在周期边界上出问题(对称框的 ±π/2 边界附近微小变化就导致损失跳变)。CSL 把角度预测重构成圆形分类绕开这个问题。基于高斯的方法把旋转框建模为二维高斯分布,用 Wasserstein 距离或 KFIoU 算相似度。但高斯建模对正方形旋转物体有角度模糊问题,后续又有人加上了专门的角度损失。PSC 引入相位编码器解决边界不连续问题,PSCD 进一步引入双频相位表示,缓解方形物体的角度模糊。S2ANet 用特征对齐做精细定位,LSKNet 用大选择核适配航拍场景里常见的长条结构。
YOLO 系列里,YOLOv8 和 YOLO11 都引入了带独立角度分支的 OBB 检测头,用 ProbIoU 训练。YOLO26 在此基础上加了一个长宽比感知的角度损失和优化的解码器,专门处理角度模糊和边界不连续问题。
2.6 开放词汇检测与分割
开放词汇检测按推理时怎么指定目标类别,可以分为三类。
文本提示。GLIP 把检测重构成短语定位,通过对比学习对齐区域特征和文本嵌入。Grounding DINO 在 Transformer 检测器里做了紧耦合跨模态融合。YOLO-World 通过可重参数化的交叉注意力把 CLIP 文本嵌入注入 YOLO 颈部,把文本条件检测带到了实时领域。不过文本提示对工业缺陷、细粒度生物标本这类难以用语言准确描述的物体不好使。
视觉提示。用参考图像或区域代替文本。OWL-ViT 和 OV-DETR 把图像样本和文本查询一起送入共享的 CLIP 编码器。DINOv 把参考区域当上下文示例用,T-Rex2 通过区域级对比训练实现更紧的多模态对齐。分割这边,SEEM 和 Semantic-SAM 支持点、框、参考掩膜等多种提示类型。
无提示。完全去掉显式查询,让检测器跟生成式语言模型配合。GRiT 给区域候选骨干接了自回归文本解码器做密集描述和检测。DetCLIPv3 用网络数据训练物体描述器,给任意区域生成标签信息。GenerateU 用语言模型自由生成物体名称,把识别跟预定义词汇表解耦。
YOLOE 是第一个在单个实时模型里统一了文本提示、视觉提示和无提示三种范式的方案,靠的是 RepRTA、SAVPE 和 LRPCHead 这三个组件。YOLOE-26 继承了这套设计,进一步换上了更强的骨干、升级的文本编码器(MobileCLIP2)、伪标签数据引擎和解耦分割训练。
方法论:核心检测架构与训练
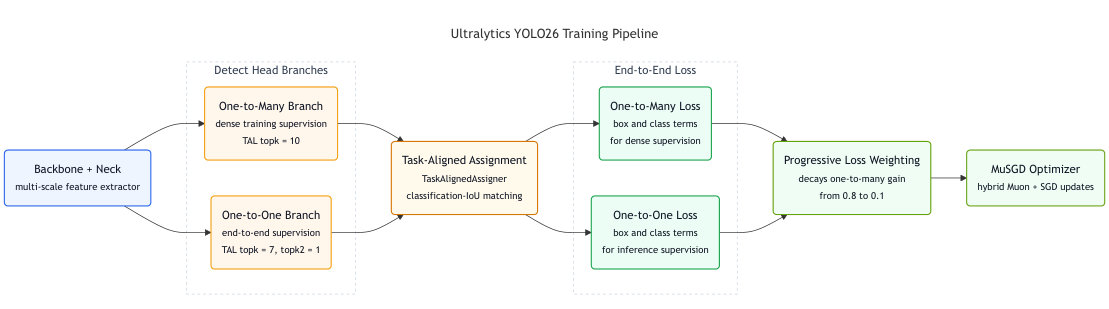
YOLO26 相对于 YOLO11 的改进,围绕三个设计目标展开:端到端简洁性、部署效率和更强的优化。具体通过三条路径实现:原生无 NMS 的一对一推理路径、轻量的无 DFL 回归头、以及由 MuSGD + Progressive Loss + STAL 组成的训练管线。
3.1 架构设计
3.1.1 端到端无 NMS 检测
大多数 CNN 检测器推理时依赖 NMS 去除重复预测。YOLO26 采用双头设计,同时支持无 NMS 的端到端解码和传统的密集预测,按需选择。
一对一检测头(默认)。输出固定尺寸的预测集合,不需要 NMS,每张图最多输出 300 个检测结果。沿用 YOLOv10 的方案,两个头都用 TAL 做标签分配,但匹配数量不同。一对一通路先用 topk=7 构建 TAL 候选集,再用 topk2=1 做二次筛选,每个真实框只保留唯一匹配,推理时直接解码。
一对多检测头。保留标准的密集 YOLO 风格预测,TAL 用 topk=10,提供更丰富的正监督。推理时仍用 NMS,精度通常更高一点,代价是多一道后处理。
简单说就是给了用户一个选择开关:要简洁快速用一对一,要极致精度用一对多。
3.1.2 移除分布聚焦损失(DFL)
DFL 自 YOLOv8 起被广泛使用,每个框的每一边预测为 K 个 bin(通常 K=16)上的离散分布,按期望值解码:
这意味着回归从 4 个标量变成了每个位置 4K 个 logits,检测头的参数和计算量随之膨胀。论文给过一个数据:YOLO11n 去掉 DFL 后参数从 2.6M 降到 2.3M,FLOPs 从 6.5 降到 5.2——这一刀砍掉了 12% 的参数和 20% 的计算量。
DFL 还有回归范围限制。由于
YOLO26 的选择是彻底移除 DFL,换一个更简单的回归头,然后用 Progressive Loss 和 STAL 来补回定位质量。这个决策在论文的消融实验中有详细验证——尤其在 1280 分辨率训练下,无 DFL 的检测头对大物体的覆盖更完整。
移除 DFL 还简化了模型导出,对 TensorRT、ONNX 这些后端的兼容性更好。
3.2 训练方法
3.2.1 MuSGD 优化器
MuSGD 是一个混合优化器,把 Muon 和标准 SGD-momentum 结合了起来。
Muon 的做法:先算动量更新,然后对动量得出的更新做一次轻量正交化(通过几轮 Newton-Schulz 迭代),让更新方向的条件更好、训练更稳。这个思路从 LLM 训练那边借鉴过来,YOLO26 把它用到了检测器训练上。
具体来说:对多维参数(卷积核、线性层权重),MuSGD 混合 Muon 和 SGD 的更新;对一维参数(偏置、归一化层的 scale),只用纯 SGD。这种按参数类型拆分的方式,既能让高维权重从正交化更新中受益,又保持了一维参数(scale/shift)的稳定,实际训练中收敛更快。
3.2.2 Progressive Loss
双头检测器有个天然的优化不对称问题:密集的一对多分支正监督更充分,早期容易优化;一对一分支约束更紧,但决定最终的推理行为。如果用固定的相同损失权重从头训到尾,推理用的一对一分支很可能训练不足。
Progressive Loss 就是干这个的——一个课程式的重新加权策略,随着训练逐步把优化重心从密集分支转移到一对一分支。前期的密集分支稳住特征学习,后期一对一分支拿到更多梯度信号。
总检测损失写成:
其中
3.2.3 小目标感知标签分配(STAL)
TAL 的候选筛选有一个硬伤:锚点中心必须落在真实框内部。对于小物体,经过多层特征图降采样后,框内可能一个锚点中心都没有——这个物体在训练中就拿不到任何正样本,定位和分类信号都为零。
STAL 的思路很直接:把候选筛选用的几何和回归用的几何解耦。对候选筛选这一步,把过小的真实框「膨胀」一下。
具体做法:设一个真实框为
关键点:STAL 只改了候选筛选的掩膜。原始的
任务特定扩展
共享的检测架构和训练方法之外,YOLO26 还为实例分割、姿态估计和旋转框检测做了专门的扩展。它们共享同样的骨干和颈部,但在检测头和监督方案上各有调整。
分类分支这块比较简单,直接复用标准分类头,没有引入新的解码逻辑,不算方法论贡献。
实例分割
YOLO 风格的分割一直走基于原型的路线:每张图预测一个共享的原型张量,每个正实例预测一个系数向量,两者组合重建掩膜。给定原型张量
YOLO26 在这套框架上做了两个改进。
多尺度原型模块。之前的标准做法只用最高分辨率特征
辅助语义分割损失。YOLO26 额外加了一个只在训练时启用的语义分割分支,从
姿态估计
以前的 YOLO 姿态模型直接回归关键点坐标
YOLO26 引入残差对数似然估计(RLE),加上了一套每关节的不确定性建模。具体来说,除了坐标输出,还用一个并行的 sigma 分支预测每个关节的逐轴不确定度
一个共享的 RealNVP 归一化流估计
展开看就是
旋转框检测
角度定义的改变。之前 YOLO 的 OBB 模型用 OpenCV 约定:角度取框宽与 x 轴正半轴的锐角,范围
YOLO26 改为 long-edge 定义(参考 MMRotate):角度范围
直接角度预测。以前的模型用 sigmoid 变换压缩角度:
YOLO26 改为直接预测:
针对方形物体的角度损失。YOLO11 用的 ProbIoU 损失在宽 ≈ 高时对角度变化不敏感——高斯表示在旋转下几乎不变,角度预测变得模糊而不稳定。
解决思路:因为旋转矩形在
角度损失为:
其中
模型变体与部署
YOLO26 提供了统一的模型家族,覆盖五个规模(n/s/m/l/x),支持目标检测、实例分割、图像分类、姿态估计和旋转检测。每个变体都支持训练、验证、推理和原生 PyTorch 检查点。
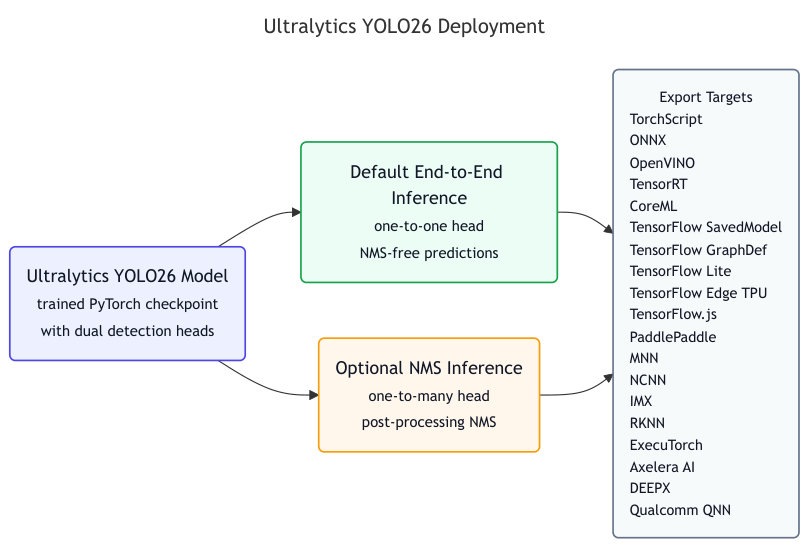
部署方面,除了 PyTorch 之外还支持 19 种导出目标:TorchScript、ONNX、OpenVINO、TensorRT、CoreML、TensorFlow SavedModel / GraphDef / Lite / Edge TPU / js、PaddlePaddle、MNN、NCNN、IMX、RKNN、ExecuTorch、Axelera AI、DEEPX、Qualcomm QNN——基本覆盖了你能想到的所有推理后端。
推理时有两条路可选:
- 默认端到端路径:走一对一检测头,不需要 NMS,输出固定尺寸
- 可选 NMS 路径:走一对多检测头,配合 NMS 后处理,精度略高
有些运行时环境不支持端到端解码所需的 top-K 操作,导出时会自动回退到非端到端分支。
性能方面,YOLO26n 在 ONNX 格式下比 YOLO11n CPU 推理速度提升最高 43%(在 Intel Xeon @ 2.00 GHz 上测试),同时模型体积和内存占用也更小——这对没有 GPU 的边缘部署场景很实用。
YOLOE-26:开放词汇检测与分割
YOLOE-26 是 YOLO26 的开放词汇扩展,继承了 YOLOE 的三种推理模式(文本提示、视觉提示、无提示),在 YOLO26 检测器基础上做了四点升级。
基础框架
YOLOE 的开放词汇检测基于 BNContrastiveHead。检测特征图分别走两个分支:
YOLOE 分三个阶段训练:文本提示阶段(TP)、视觉提示阶段(VP)、无提示阶段(PF)。TP 阶段是共享初始化,VP 和 PF 各自从 TP 检查点独立微调。
YOLOE-26 的四点改进
1. 骨干升级。原来基于 YOLO11 的检测器替换为 YOLO26 的骨干、颈部和端到端检测栈。TP 模型从已发布的 YOLO26 预训练权重初始化,把闭集检测的改进直接迁移到开放词汇场景。
2. 文本编码器升级。从 MobileCLIP 升级到 MobileCLIP2,文本-视觉对齐能力更强。
3. 伪标签数据引擎。论文在可视化训练集时发现,标注中有大量物体未标注,但对训练好的 YOLOE 模型来说其实可以可靠检测出来。于是用预训练的 YOLOE 教师模型配合内置的 4585 类词汇表对训练集做了一轮伪标签补充:那些原始标注中没有的、与任何真实框 IoU < 0.5 且置信度 > 0.5 的预测框,作为伪标签追加到训练集中,再用扩充后的数据训第二轮。
4. 解耦分割训练。分割头在初始 TP 阶段禁用,等 TP 阶段训好后再独立训练。这样骨干网络可以专注于开放词汇检测,不像原始 YOLOE 那样把分割和 TP 联合训练。一个不大但实用的调度改动。
实验与分析
YOLO26 在目标检测、实例分割、姿态估计、旋转框检测和开放词汇检测上做了全面评估。下面先讲实验设置和消融实验,再看 COCO 主结果、多任务结果和 YOLOE-26 结果。
4.1 实验设置
训练方案。COCO 检测模型采用两阶段训练:先在 Objects365-v1 上预训练 150 个 epoch,再在 COCO 上微调。微调 epoch 数按模型规模设置:n/s/m/l/x 分别用 245/70/80/60/40 个 epoch,全局 batch size 为 128。
数据增广。按模型规模调整增广强度——大模型用更强的 scale、mixup 和 copy-paste,YOLO26n 用最轻度的方案。Mosaic 在大部分训练阶段使用,训练末期通过 close mosaic 调度逐渐关闭。
Progressive Loss 参数。一对多/一对一损失权重初始化为 (0.8, 0.2),线性过渡到 (0.1, 0.9),每个 epoch 更新一次。这个配置在全部实验中固定。
STAL 参数。三级检测金字塔 strides [8, 16, 32],
4.2 全局消融:从 YOLO11s 到 YOLO26s
论文的 Table 2 报告了从 YOLO11s 基线到 YOLO26s 的逐步演进,同时给出 E2E 和 NMS 两条路径的 AP。前四步改动只作用于 NMS 路径(端到端头尚未启用),从第 5 步开始才有 E2E AP。一步步来看:
- 移除 DFL:AP 从 47.0 降到 46.4(-0.6),但参数量减少 0.3M、FLOPs 减少 1.4G、延迟降低 0.2ms
- 加 L1 Loss:AP 回到 46.6(+0.2)
- 加 STAL:AP 回到 46.8(+0.2)
- 骨干/颈部微调(在颈部插入一个额外的注意力层):AP 回到 47.0(+0.2),延迟几乎不变
- 启用端到端 + Progressive Loss:E2E AP 达到 46.7(此时 NMS 路径 AP 为 47.2)
- 加 MuSGD:E2E AP 提升到 47.1(NMS 路径 47.6)
- Objects365 预训练:E2E AP 到 47.4(NMS 路径 48.0)
- 超参搜索:最终 E2E AP 47.8,NMS 路径 AP 48.6
结论很清楚:DFL 对精度的贡献完全可以被更简单的组件替代,移除后模型更轻更快。
4.3 核心设计消融
4.3.1 DFL 移除
论文做了更严格的控制实验:在相同条件下分别用/不用 DFL 训练 YOLO26s,只看图像尺寸的影响。
| 分辨率 | DFL | AP | AP |
AP |
AP |
|---|---|---|---|---|---|
| 640 | 有 | 46.0 | 27.3 | 50.4 | 62.8 |
| 640 | 无 | 46.3 | 27.9 | 50.6 | 63.8 |
| 1280 | 有 | 49.8 | 36.0 | 55.7 | 61.8 |
| 1280 | 无 | 51.1 | 35.9 | 55.2 | 64.0 |
关键发现:
- 640 下,去掉 DFL 提升 +0.3 AP,AP
提升 +1.0 - 1280 下,增益更明显:+1.3 AP,AP
提升 +2.2
这说明 DFL 的有限回归范围确实是个问题——分辨率越高,大物体的回归距离越长,限制越明显。直接回归在 1280 下表现更好。
4.3.2 MuSGD
对比标准 SGD 训 600 epoch 和 MuSGD 训 500 epoch:
| 优化器 | Epochs | COCO mAP |
|---|---|---|
| SGD | 600 | 47.0 |
| MuSGD | 500 | 47.4 |
MuSGD 少用 16.7% 的训练时间,精度还高了 0.4。论文还补充了在 ImageNet 分类上的验证,结论相同。
4.3.3 Progressive Loss
在 YOLO11s 基线上测试了几种初始/结束权重组合:
| 初始 (o2m, o2o) | 结束 (o2m, o2o) | E2E mAP |
|---|---|---|
| (0.5, 0.5) | (0.5, 0.5) | 46.4 |
| (1.0, 0.0) | (0.1, 0.9) | 46.4 |
| (0.8, 0.2) | (0.1, 0.9) | 46.7 |
初期完全抑制一对一并不好,从头开始就得给一对一分支一点梯度;最优调度是 (0.8, 0.2) → (0.1, 0.9)。
4.3.4 STAL
| 方法 | AP | AP |
AP |
AP |
|
|---|---|---|---|---|---|
| TAL(基线) | - | 46.6 | 29.0 | 51.4 | 63.9 |
| STAL | 8 | 46.6 | 27.7 | 51.6 | 63.8 |
| STAL | 16 | 46.8 | 29.6 | 51.6 | 63.8 |
| STAL | 32 | 46.5 | 28.3 | 51.3 | 63.7 |
(太弱):对小物体没用,AP 反而下降 (最佳):AP +0.2,AP 从 29.0 提升到 29.6 (太大):过度膨胀破坏了原有的尺度先验,AP 下降
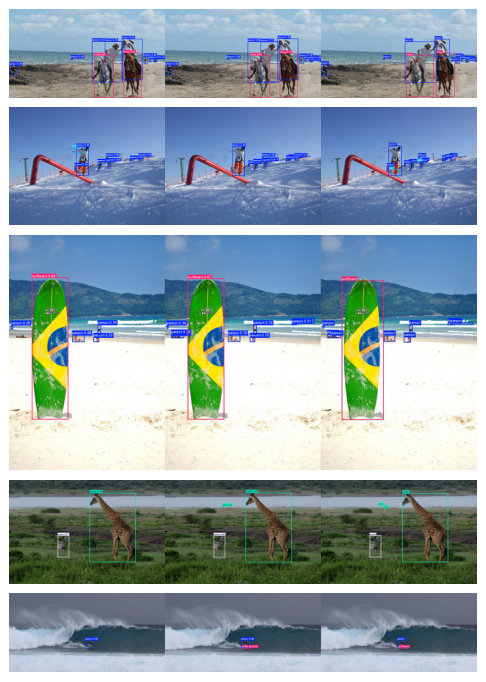
4.4 COCO 主结果
| 模型 | 尺寸 | mAP | mAP (E2E) | CPU ONNX(ms) | T4 TRT10(ms) | Params(M) | FLOPs(B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 | 1.7 | 2.4 | 5.4 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 | 2.5 | 9.5 | 20.7 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 | 4.7 | 20.4 | 68.2 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 | 6.2 | 24.8 | 86.4 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 | 11.8 | 55.7 | 193.9 |
E2E vs NMS 的灵活性。一对一头的 E2E 路径比一对多+NMS 路径只低 0.6–0.8 AP,差距很小。这意味着大多数场景下直接用 E2E 路径就行,不需要 NMS。如果硬件支持 NMS 且追求极致 AP,也可以切回一对多路径。
跟其他实时检测器的对比见论文附录 Table S8,YOLO26 在中到大规模上 AP-延迟权衡最优。
4.5 多任务结果
4.5.1 实例分割
在 YOLO11s 上测试两个改进:
| 方法 | mAP | AP50 |
|---|---|---|
| YOLO11s(基线) | 32.0 | 51.1 |
| + 多尺度原型模块 | 32.4 | 51.7 |
| + 辅助语义损失 | 32.7 | 52.0 |
多尺度原型模块将 mAP 从 32.0 提升到 32.4,辅助语义损失(BCE + Dice 等权重)进一步提升到 32.7,且推理零开销。
集成到完整 YOLO26 后(见附录 Table S9),相比 YOLO11 全系列提升:box AP +1.6 到 +2.5,mask AP +2.4 到 +3.7。
4.5.2 姿态估计
RLE 的权重配置消融:
| mAP | ||
|---|---|---|
| 48 | 0 | 61.5 |
| 48 | 1 | 60.8 |
| 24 | 1 | 63.0 |
| 24 | 2 | 62.5 |
| 12 | 1 | 62.6 |
| 0 | 1 | 61.9 |
| 0 | 2 | 62.4 |
最佳配置
完整系列对比(附录 Table S10):E2E 设定下 YOLO26 相比 YOLO11 提升 pose AP +2.1 到 +7.2,E2E 和 NMS 变体差距不超过 0.2 AP。
4.5.3 旋转框检测
在 DOTA-v1.0 上验证(2806 张图、15 类、188282 实例,切成 1024×1024 块训练)。
角度定义对比
| 角度定义 | mAP | AP50 |
|---|---|---|
| 47.7 | 75.0 | |
| 49.0 | 75.4 |
Long-edge 定义直接提升 +1.3 mAP。
角度损失
| mAP | AP50 | |
|---|---|---|
| -(不用) | 49.0 | 75.4 |
| 1 | 49.4 | 75.5 |
| 2 | 49.5 | 75.4 |
| 3 | 50.2 | 76.0 |
| 4 | 49.8 | 75.7 |
| 5 | 47.1 | 75.5 |
完整系列对比(附录 Table S11):YOLO26 相比 YOLO11 提升 OBB mAP +2.5 到 +3.4,AP75 提升达 +4.6 到 +6.0(定位更严格的指标下提升更明显)。
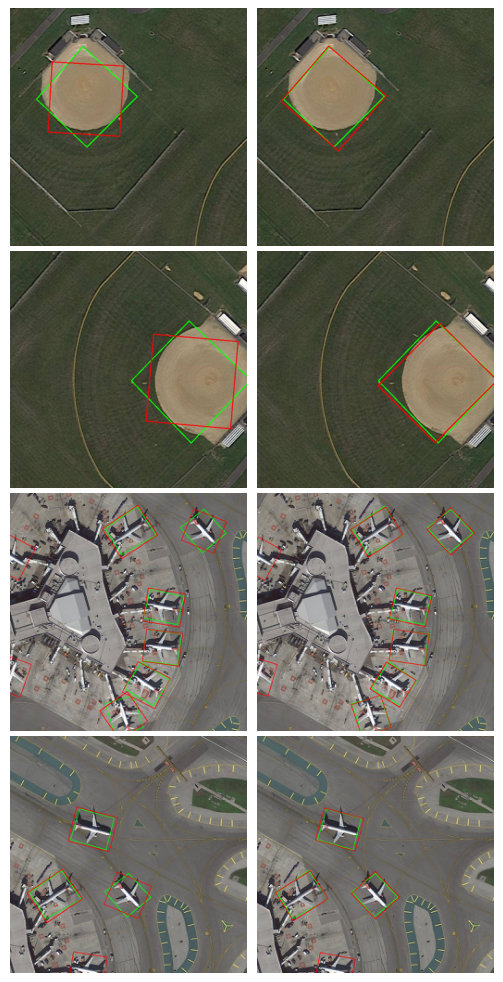
4.6 YOLOE-26 结果
4.6.1 消融实验
从 YOLOE-11s-TP 基线出发,逐步加入四项改进:
| 模型 | 骨干升级 | 解耦分割 | 文本编码器 | 数据引擎 | AP |
AP |
|---|---|---|---|---|---|---|
| YOLOE-v8s | - | - | - | - | - | 27.9 |
| YOLOE-11s | - | - | - | - | - | 27.5 |
| 26s | ✓ | - | - | - | 27.8 | 29.0 |
| 26s | ✓ | ✓ | - | - | 28.5 | 29.5 |
| 26s | ✓ | ✓ | ✓ | - | 28.8 | 29.7 |
| 26s | ✓ | ✓ | ✓ | ✓ | 29.9 | 31.0 |
- 骨干升级(YOLO11s → YOLO26s):+1.5 AP(non-E2E)
- 解耦分割训练:+0.5 AP(去掉分割目标的干扰)
- 文本编码器升级(MobileCLIP → MobileCLIP2):+0.2 AP
- 数据引擎(伪标签补充):+1.3 AP,提升最大
4.6.2 基于提示的评估
完整结果见附录 Table S12。YOLOE-26 在文本和视觉提示下全面超越之前版本:
- 文本提示:YOLOE-26x 达到 40.6 AP,超过 DetCLIP-T 达 +6.2 AP
- 视觉提示:YOLOE-26x 达到 38.5 AP
- 小型 YOLOE-26n 仅 3.9M 参数也有 24.7 AP
零样本分割方面(附录 Table S13),YOLOE-26x 达到 27.4 / 26.7 AP
4.6.3 无提示评估
完整结果见附录 Table S14。无提示设定下,YOLOE-26 同样保持竞争力,YOLOE-26x 最高达 31.1 AP(non-E2E)。E2E 头与 non-E2E 的差距控制在 0.7–1.2 AP 之间,说明了端到端路径的有效性。
结论
YOLO26 是一个统一的实时视觉模型家族,核心贡献可以归结为:双头无 NMS 架构 + MuSGD + Progressive Loss + STAL + 移除 DFL,在这套组合下实现了更轻的检测头、更强的优化和更准的小物体检测。
多任务扩展同样扎实:分割提了最高 +3.7 mask AP,姿态提了最高 +7.2 AP,旋转检测提了最高 +3.4 mAP。COCO 上 40.9–57.5 mAP 的指标覆盖了 n 到 x 全系列,延迟在 1.7–11.8 ms 之间。
开放词汇方面,YOLOE-26x 在 LVIS minival 上文本提示达到 40.6 AP、视觉提示达到 38.5 AP、无提示达到 31.1 AP。
未来工作方向包括:扩展到 COCO 以外的更多基准、探索更灵活的损失调度策略(不只是线性